

.svg)


Аналитика данных на собеседовании проверяют с трёх сторон: умеете ли вы достать данные, можно ли доверять вашему выводу и понимает ли бизнес, что с этим выводом делать. Отсюда и набор вопросов: SQL, Python, статистика, метрики и эксперименты.
Ниже собраны вопросы на собеседовании аналитика данных с разбором ответов для Junior, Middle и Senior. Отдельно разберём вопросы об опыте, рабочие кейсы и практические задания: SQL-задачу, обработку данных в pandas и интерпретацию A/B-теста.
Материал актуален на сентябрь 2026 года. Стек в вакансиях за последние годы почти не поменялся: SQL, Python с pandas, BI-инструмент, иногда Airflow и dbt. Поменялись детали. Например, в pandas 3.0 по умолчанию включены Copy-on-Write и отдельный строковый тип, и про это уже спрашивают.
Как проходит собеседование на аналитика данных
Количество и порядок этапов зависят от компании. В крупных продуктовых командах обычно 3–5 встреч, в небольших компаниях технический и финальный этапы часто объединяют в одну. Типичная схема выглядит так:
| Этап | Что проверяют | Что подготовить |
|---|---|---|
| Разговор с рекрутером, 20–30 минут | Опыт, домен, стек, зарплатные ожидания, формат работы | Рассказ на 2 минуты: какие данные, какие задачи, какой результат |
| SQL-секция, 45–90 минут | JOIN, агрегации, оконные функции, работа с NULL и дублями | Решение задач вслух в онлайн-редакторе без автодополнения |
| Python и статистика | pandas, распределения, доверительные интервалы, A/B-тесты | Объяснение p-value и ошибок простыми словами |
| Кейс или тестовое задание | Ход мысли: гипотезы, декомпозиция метрики, выбор данных | Структуру разбора падения метрики и дизайн эксперимента |
| Встреча с руководителем и командой | Коммуникация со стейкхолдерами, приоритизация, мотивация | 2–3 истории из опыта с результатом и вашими решениями |
Грейд меняет не столько набор этапов, сколько глубину. У Junior почти всегда подробно проверяют SQL и базовую статистику. Middle дают задачи на когорты, оконные функции и эксперименты. У Senior техническую часть часто сокращают и смотрят на дизайн метрик, работу с неопределённостью и влияние на решения бизнеса.
Посмотреть, какой стек сейчас просят работодатели, можно в подборке вакансий аналитика данных на HireHi.
Какие вопросы задают на собеседовании аналитику данных
Вопросы обычно делятся на шесть типов. Ниже в статье каждый тип разобран отдельно, поэтому здесь только карта.
- Технические вопросы по SQL: от разницы WHERE и HAVING до retention по когортам.
- Python и pandas: структуры данных, объединение таблиц, пропуски, особенности версий.
- Статистика и эксперименты: распределения, доверительные интервалы, p-value, мощность, размер выборки.
- Метрики и бизнес-логика: DAU, конверсия, ARPU, декомпозиция выручки.
- Вопросы об опыте: самый полезный анализ, ошибка в данных, спор со стейкхолдером.
- Ситуационные кейсы и практические задания: падение метрики, неоднозначный тест, SQL-задача на время.
Проговорите ответы аналитика вслух
Выберите «Аналитик данных» и грейд, пройдите голосовое интервью с ИИ-интервьюером и посмотрите, где объяснение метрики или теста звучит неуверенно.
Профессиональные вопросы и ответы на собеседовании аналитика данных
Вопросы сгруппированы по грейдам: у аналитиков данных разница в ожиданиях между Junior, Middle и Senior выражена сильно. Внутри грейда вопросы разбиты по темам. Ответы даны как логика сильного ответа, а не текст для заучивания.
Вопросы для Junior аналитика данных
От начинающего аналитика ждут уверенного SQL, понимания базовой статистики и умения объяснить, зачем нужен каждый инструмент. Сложные модели на этом уровне почти не спрашивают.
SQL: базовые запросы
1. Чем WHERE отличается от HAVING?
Что проверяют: понимание порядка выполнения запроса. WHERE фильтрует строки до группировки, HAVING фильтрует группы после агрегации. Поэтому условие на COUNT(*) или SUM() пишут в HAVING. Сильный ответ добавляет пример: «города, где больше 100 заказов» решаются через GROUP BY city HAVING COUNT(*) > 100.
2. Чем LEFT JOIN отличается от INNER JOIN и когда LEFT JOIN превращается в INNER?
INNER JOIN оставляет только строки с совпадением в обеих таблицах, LEFT JOIN сохраняет все строки левой таблицы. Вторая часть вопроса ловит частую ошибку: если условие на правую таблицу поставить в WHERE, строки без совпадений отфильтруются и LEFT JOIN фактически станет INNER. Такое условие переносят в ON.
3. Чем COUNT(*) отличается от COUNT(column) и COUNT(DISTINCT column)?
COUNT(*) считает все строки, COUNT(column) пропускает NULL в этом столбце, COUNT(DISTINCT column) считает уникальные непустые значения. На собеседовании хорошо сразу сказать, какой вариант нужен для «числа пользователей» (DISTINCT user_id), а какой для «числа событий».
4. В каком порядке выполняются части SELECT-запроса?
Логический порядок: FROM и JOIN, WHERE, GROUP BY, HAVING, SELECT, DISTINCT, ORDER BY, LIMIT. Из этого следует, почему алиас из SELECT нельзя использовать в WHERE, но обычно можно в ORDER BY.
5. Как найти дубликаты в таблице?
Сгруппировать по столбцам, которые должны быть уникальными, и отфильтровать HAVING COUNT(*) > 1. Если нужно оставить одну запись, используют ROW_NUMBER() OVER (PARTITION BY ключ ORDER BY дата) и берут строки с номером 1. Хороший ответ спрашивает, что считать дублем: полное совпадение строки или совпадение бизнес-ключа.
Python и pandas
6. Чем Series отличается от DataFrame?
Series это одномерный столбец значений с индексом, DataFrame это таблица из нескольких Series с общим индексом. Выбор df['col'] возвращает Series, df[['col']] возвращает DataFrame. Разница важна, когда результат передают дальше в функции, которые ждут таблицу.
7. Чем loc отличается от iloc?
loc выбирает по меткам индекса и названиям столбцов, iloc выбирает по порядковым позициям. Срез loc включает правую границу, iloc нет. После фильтрации индекс идёт с пропусками, поэтому df.loc[0] и df.iloc[0] могут вернуть разные строки.
8. Чем merge отличается от concat?
merge соединяет таблицы по ключу, как JOIN в SQL, с параметром how: inner, left, right, outer. concat склеивает таблицы по строкам или столбцам без сопоставления ключей. После merge полезно сверить число строк: если оно выросло, ключ в правой таблице не уникален. Для контроля есть параметр validate='one_to_one' или 'many_to_one'.
9. Как работать с пропусками в данных?
Сначала понять природу пропуска: ошибка сбора, «событие не произошло» или значение неизвестно. От этого зависит решение: удалить строки, заполнить нулём, медианой, предыдущим значением или оставить как отдельную категорию. isna().sum() показывает масштаб. Заполнять пропуски средним без объяснения причины на собеседовании считается слабым ответом.
10. Что изменилось в pandas 3.0 и почему это важно аналитику?
С версии 3.0 по умолчанию работает Copy-on-Write: любая выборка ведёт себя как копия. Цепочка вроде df[df.city == 'Moscow']['price'] = 0 больше не меняет исходную таблицу, писать нужно через df.loc[условие, 'price'] = 0. Второе изменение: строковые столбцы по умолчанию получают отдельный тип str вместо object. Если в компании старый код, при обновлении проверяют такие места.
Статистика
11. Когда медиана полезнее среднего?
Когда распределение скошено или есть выбросы: средний чек, зарплаты, время на сайте. Пара крупных заказов сильно сдвигает среднее, а медиана остаётся устойчивой. Хороший ответ добавляет, что для бизнеса иногда важно именно среднее, например для расчёта выручки, поэтому смотрят обе метрики.
12. Чем дисперсия отличается от стандартного отклонения и что такое стандартная ошибка среднего?
Дисперсия это средний квадрат отклонения от среднего, стандартное отклонение это корень из неё в тех же единицах, что и данные. Стандартная ошибка среднего показывает разброс оценки среднего между выборками и равна стандартному отклонению, делённому на корень из размера выборки. С ростом выборки она уменьшается, а стандартное отклонение данных нет.
13. Как объяснить доверительный интервал?
95-процентный интервал строят методом, который при многократном повторении эксперимента накрывает истинное значение в 95% случаев. Утверждение «истинное значение лежит в интервале с вероятностью 95%» формально неточно, и интервьюеры это ловят. Подробнее про интерпретацию есть в разборе доверительного интервала.
Визуализация и BI
14. Как выбрать тип графика?
От вопроса, на который отвечает график. Динамика во времени показывается линией, сравнение категорий столбцами, распределение гистограммой или boxplot, связь двух величин диаграммой рассеяния. Круговая диаграмма уместна для 2–4 долей одного целого. Сильный ответ упоминает аудиторию: руководителю нужен один вывод на график, а не всё сразу.
15. Что проверите в дашборде перед тем, как отдать его бизнесу?
Сверку цифр с источником хотя бы по одной метрике, фильтры по датам и часовым поясам, одинаковые определения метрик на всех вкладках, поведение при пустых данных и время загрузки. Отдельно подпись: что именно считается и откуда данные.


Вопросы для Middle аналитика данных
На уровне Middle ждут, что вы решаете типовые задачи без подсказок и понимаете ограничения своих методов. Больше вопросов про когорты, оконные функции и эксперименты.
SQL: оконные функции и когорты
16. Чем ROW_NUMBER отличается от RANK и DENSE_RANK?
Все три нумеруют строки внутри окна. ROW_NUMBER даёт уникальные номера даже при равных значениях. RANK даёт одинаковый номер равным и пропускает следующие: 1, 1, 3. DENSE_RANK не пропускает: 1, 1, 2. Для «второй по величине зарплаты» с дублями подходит DENSE_RANK. Больше примеров в разборе оконных функций SQL.
17. Как посчитать нарастающий итог и скользящее среднее за 7 дней?
Нарастающий итог: SUM(revenue) OVER (ORDER BY day ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW). Скользящее среднее: AVG(revenue) OVER (ORDER BY day ROWS BETWEEN 6 PRECEDING AND CURRENT ROW). Важная деталь: если в данных пропущены дни, ROWS считает строки, а не календарные дни. Поэтому сначала строят полный календарь дат.
18. Как посчитать retention 7-го дня по когортам?
Определить когорту по дате первого действия пользователя, затем проверить, было ли действие ровно на 7-й день или в любой день после. Retention равен вернувшимся, делённым на размер когорты. До запроса стоит уточнить определение: day-N или rolling, что считается активностью, в каком часовом поясе режем дни.
19. Запрос выполняется 20 минут. Что будете делать?
Посмотреть план через EXPLAIN или EXPLAIN ANALYZE, проверить, фильтруются ли данные до JOIN, нет ли SELECT * по широким таблицам и лишних DISTINCT. Затем использовать партиции по дате и индексы, если они есть в хранилище. Подробно о чтении плана рассказано в статье про медленные SQL-запросы.
Метрики и бизнес-логика
20. Чем ARPU отличается от ARPPU?
ARPU это выручка, делённая на всех активных пользователей. ARPPU это выручка, делённая только на платящих. ARPU = ARPPU × доля платящих. Эта формула помогает понять, выросла ли выручка за счёт того, что платить стали больше людей, или за счёт того, что платящие стали тратить больше.
21. Как декомпозировать выручку?
Выручка = пользователи × конверсия в покупку × среднее число покупок × средний чек. Каждый множитель дальше режется по каналам, платформам, регионам и когортам. Декомпозиция показывает, какой именно множитель изменился, и сужает круг гипотез. Схема разобрана в статье о декомпозиции метрик.
22. Конверсия в покупку выросла, а выручка упала. Как такое возможно?
Вероятнее всего, упал средний чек: покупать стали чаще, но дешевле. Возможна скидка, смена ассортимента в выдаче или приток другой аудитории. Второй вариант: конверсия выросла из-за уменьшения знаменателя, например после отсечения ботов. Проверяют через декомпозицию и сравнение сегментов.
23. Что такое DAU/MAU и что он показывает?
Отношение дневной аудитории к месячной показывает, как часто пользователи возвращаются. Значение сильно зависит от типа продукта: для мессенджера естественна высокая частота, для сервиса покупки билетов низкая. Поэтому сравнивать DAU/MAU корректно с похожими продуктами или с самим собой во времени.
A/B-тесты
24. Что такое p-value простыми словами?
Это вероятность увидеть такую же или более сильную разницу между группами при условии, что на самом деле эффекта нет. Маленький p-value говорит, что наблюдаемая разница плохо объясняется случайностью. Он не говорит, насколько велик эффект и с какой вероятностью гипотеза верна. Если интервьюер просит пример, подойдёт тест кнопки оплаты с 20 000 пользователей в группе.
25. Что такое ошибки первого и второго рода в бизнес-терминах?
Ошибка первого рода: раскатили изменение, которое на самом деле не работает. Ошибка второго рода: отказались от изменения, которое помогало бы. Уровень значимости контролирует первую ошибку, мощность теста (обычно 80%) вторую. Цена ошибок разная, поэтому пороги иногда выбирают под задачу.
26. От чего зависит размер выборки для теста?
От базового значения метрики и её разброса, минимального эффекта, который хотим заметить (MDE), уровня значимости и мощности. Чем меньше MDE, тем больше пользователей нужно. Если трафика не хватает, тест либо дольше длится, либо ловит только крупные эффекты, и это надо проговорить с командой до запуска.
27. Почему нельзя каждый день смотреть на p-value и останавливать тест при первой значимости?
Многократные проверки раздувают вероятность ложноположительного результата намного выше заявленных 5%. Это называют peeking. Решения: зафиксировать длительность заранее, использовать последовательные методы тестирования или поправки на промежуточные проверки. Тест обычно держат не меньше одного-двух полных недельных циклов.
28. Что такое SRM и почему его проверяют первым?
Sample Ratio Mismatch: группы разделились не в запланированной пропорции, например 52/48 вместо 50/50 на большом трафике. Это признак бага в сплите или логировании. При SRM результаты теста нельзя интерпретировать, пока не найдена причина. Проверяют критерием хи-квадрат по числу пользователей в группах.
Качество данных
29. Как отличить выброс-ошибку от выброса-инсайта?
Проверить источник: логирование, дубли, тестовые аккаунты, смену единиц измерения. Если данные корректны, выброс может быть реальным поведением, например оптовым покупателем. Его не удаляют молча, а выносят в отдельный сегмент и показывают влияние на итог. Приёмы собраны в материале про аномалии в данных.
30. Как убедиться, что двум отчётам с разными цифрами можно верить?
Сравнить определения метрик, фильтры, часовые пояса, окно атрибуции и момент выгрузки. Затем сверить на уровне отдельных записей: взять один день и найти строки, которые есть в одном отчёте и нет в другом. Расхождение почти всегда объясняется определением, а не «глюком».


Вопросы для Senior аналитика данных
Senior-аналитика спрашивают меньше про синтаксис и больше про решения: какую метрику выбрать, как оценить эффект без чистого эксперимента и как выстроить аналитику, которой доверяют.
31. Как выбрать главную метрику продукта и чем её защитить?
Главная метрика должна отражать ценность для пользователя и связь с деньгами, например число завершённых заказов для маркетплейса. К ней добавляют guardrail-метрики, которые нельзя ухудшить: отмены, жалобы, время загрузки, маржу. Сильный ответ объясняет, как метрика декомпозируется на рычаги, которыми управляют команды.
32. Как оценить эффект, если A/B-тест провести нельзя?
Использовать квазиэкспериментальные методы: разницу разностей (difference-in-differences) с похожим контрольным регионом, синтетический контроль, регрессионный разрыв. Обязательно назвать допущения, например параллельные тренды до запуска, и проверить их на исторических данных. Подробнее в разборе каузального вывода.
33. Как сократить длительность A/B-тестов без потери мощности?
Снизить дисперсию метрики: CUPED с предэкспериментальными данными, стратификация, отсечение выбросов по заранее заданному правилу. Выбирать более чувствительные прокси-метрики, если доказана их связь с целевой. Не решать задачу снижением порога значимости.
34. Что такое парадокс Симпсона и где вы его встречали?
Тренд в каждом сегменте направлен в одну сторону, а в сумме в обратную из-за разного веса сегментов. Пример: конверсия выросла на iOS и на Android, но общая упала, потому что доля трафика сместилась на платформу с низкой конверсией. Поэтому выводы по общей метрике проверяют в разрезе ключевых сегментов.
35. Как приоритизировать запросы, если их больше, чем может сделать команда?
Оценить каждый запрос по влиянию на решение и срочности. Спросить у заказчика, какое решение изменится после ответа. Регулярные отчёты автоматизировать, повторяющиеся вопросы закрыть самообслуживанием в BI. Запросы без решения за ними обсуждать и откладывать открыто, а не молча.
36. Как добиться, чтобы разные команды считали метрики одинаково?
Завести справочник метрик с формулой, владельцем и источником, считать метрики в одном слое, например в dbt-моделях, а не в каждом дашборде отдельно. Изменения определений версионировать и объявлять. Пример такого подхода есть в статье про справочник метрик.


Проверьте, как звучат ответы про метрики и тесты
Технический формат тренажёра задаёт вопросы по роли и грейду. После интервью видно, какие темы вы объясняете уверенно, а где ответ расплывается.
Какие вопросы задают об опыте работы аналитику данных
Вопросы об опыте проверяют, что вы делали сами, а не что делала команда. Удобная структура ответа: контекст и задача, данные и метод, ваше решение, результат для бизнеса. Это вариант STAR, где вместо «действия» стоит анализ.
- Расскажите о самом полезном анализе. Хороший ответ называет решение, которое изменилось после анализа. Пример структуры: «Отток в подписке рос. Я сравнил когорты и нашёл, что уходят после второго списания. Предложили напоминание за три дня. Отток второго месяца снизился на несколько пунктов».
- Расскажите об ошибке в ваших данных. Интервьюер ждёт, как вы её нашли, кому и когда сообщили и что изменили в процессе, чтобы ошибка не повторилась. Попытка выдать за ошибку «слишком тщательную проверку» воспринимается как уход от ответа.
- Как вы работали со стейкхолдером, который не согласен с выводом? Покажите, что вы разделяете данные и интерпретацию: перепроверили расчёт, показали альтернативные объяснения, договорились о дополнительном срезе или тесте.
- Какой отчёт или дашборд вы сделали и кто им пользуется? Здесь важны пользователи и частота использования, а не число графиков. Если дашбордом перестали пользоваться, расскажите, почему, это тоже опыт.
- Какую задачу вы автоматизировали? Назовите ручной процесс, инструмент (SQL, Python, Airflow, dbt) и экономию времени или ошибок.
Junior может отвечать на эти вопросы учебными и pet-проектами, если честно их так называет. От Senior ждут масштаба: влияние на метрики команды, построенные процессы, наставничество.
Какие ситуационные вопросы могут задать аналитику данных
В ситуационном вопросе интервьюер описывает рабочую проблему и смотрит, как вы рассуждаете. Правильного ответа часто нет, оценивают структуру и вопросы, которые вы задаёте.
37. Вчера DAU упал на 15%. Ваши действия?
Сначала проверить данные: сбор событий, релизы трекинга, задержку загрузки. Затем разрезать падение по платформам, версиям приложения, странам и источникам трафика, чтобы найти, где оно сосредоточено. После этого проверить внешние причины: праздник, сбой у партнёра, изменение рекламы. В конце сформулировать гипотезы и план проверки. Интервьюеру важно, что первым шагом вы не начинаете искать «виноватую фичу».
38. Тест показал рост конверсии, но продакт сомневается. Что проверите?
SRM и корректность сплита, длительность и наличие подглядываний, согласованность с другими метриками, эффект новизны в первые дни, сегменты с противоположным знаком. Если всё чисто, доверительный интервал эффекта помогает обсуждать не «работает или нет», а «насколько и с какой неопределённостью».
39. Руководитель просит «быстро посмотреть данные» без понятного вопроса.
Уточнить, какое решение он хочет принять, какие у него гипотезы и к какому сроку нужен ответ. Затем предложить 2–3 конкретных среза, которые можно сделать быстро, и договориться о формате результата. Без этого анализ превращается в бесконечную выгрузку.
40. Вы нашли ошибку в отчёте, по которому уже приняли решение.
Сообщить владельцу решения как можно раньше, оценить масштаб ошибки и её влияние на вывод, подготовить исправленный расчёт. Отдельно объяснить, как ошибка появилась и что меняется в проверках. Доверие к аналитику держится на прозрачности, а не на отсутствии ошибок.
41. Маркетинг просит посчитать эффект кампании, которая уже прошла без контрольной группы.
Честно обозначить ограничения и предложить лучший доступный метод: сравнение с похожим периодом или регионом, разница разностей, анализ по когортам привлечения. Результат подать как оценку с допущениями, а для следующей кампании договориться о holdout-группе.
Какие практические задания дают на собеседовании аналитику данных
Практика бывает двух видов: задача на 15–30 минут прямо на интервью и тестовое на дом на несколько часов. Ниже четыре типичных задания с разбором подхода.
42. SQL: найти пользователей, которые покупали два дня подряд
Дана таблица orders(user_id, order_date). Нужно вывести пользователей, у которых есть заказы в два соседних календарных дня.
WITH days AS (
  SELECT DISTINCT user_id, order_date::date AS d
  FROM orders
),
marked AS (
  SELECT user_id, d,
         LAG(d) OVER (PARTITION BY user_id ORDER BY d) AS prev_d
  FROM days
)
SELECT DISTINCT user_id
FROM marked
WHERE d - prev_d = 1;
Что оценивают: DISTINCT до оконной функции (несколько заказов в один день не должны ломать логику), приведение к дате, выбор LAG вместо self-join. Хорошо проговорить, как поведёт себя запрос с часовыми поясами. Синтаксис вычитания дат зависит от СУБД, это тоже стоит назвать.
43. pandas: посчитать долю повторных покупателей по месяцам
Дан DataFrame с user_id и order_date. Нужно для каждого месяца посчитать долю пользователей, которые уже покупали раньше.
df["month"] = df["order_date"].dt.to_period("M")
first_month = df.groupby("user_id")["month"].transform("min")
df["is_returning"] = df["month"] > first_month

users = df.groupby("month")["user_id"].nunique()
returning = df[df["is_returning"]].groupby("month")["user_id"].nunique()
monthly = pd.DataFrame({"users": users, "returning": returning}).fillna(0)
monthly["share"] = monthly["returning"] / monthly["users"]
Что оценивают: transform вместо лишнего merge, уникальных пользователей вместо числа заказов, заполнение месяцев без повторных покупателей нулём. Хорошо сразу предложить проверку: вручную пересчитать одного пользователя и сверить число пользователей с SQL-выгрузкой.
44. Интерпретация A/B-теста
Даны две группы по 20 000 пользователей, конверсия 4,0% и 4,4%, p-value 0,03, тест шёл 5 дней. Нужно дать рекомендацию. Сильный ответ не ограничивается «значимо, раскатываем». Он проверяет SRM, отмечает, что 5 дней не покрывают полный недельный цикл, смотрит на guardrail-метрики и доверительный интервал абсолютного эффекта. Рекомендация может быть «продлить до двух недель и проверить сегменты».
45. Тестовое на дом: дашборд и выводы
Обычно дают выгрузку заказов или событий и просят ответить на 3–5 вопросов бизнеса с дашбордом. Оценивают не красоту графиков, а структуру: вопрос, метод, вывод, ограничения, следующий шаг. Обязательно приложите SQL или ноутбук и опишите допущения. Если задание занимает больше 6–8 часов, это нормальный повод уточнить объём у рекрутера.
Потренируйте разбор кейса до реального интервью
Попробуйте вслух разобрать падение метрики или спорный тест. Разбор после тренировки покажет, где не хватило структуры или проверки данных.
Как подготовиться к собеседованию на аналитика данных
Подготовку удобно строить от вакансии: выпишите стек и домен, затем закройте темы по списку ниже. Для большинства кандидатов хватает 2–4 недель регулярной практики.
- SQL: 20–30 задач на JOIN, агрегации и оконные функции с таймером. Решайте в той СУБД, которая указана в вакансии: PostgreSQL, ClickHouse или BigQuery.
- Python: pandas на уровне groupby, merge, работы с датами и пропусками. Если в вакансии есть Polars или DuckDB, посмотрите базовый синтаксис.
- Статистика: распределения, доверительные интервалы, проверка гипотез, размер выборки. Тренируйте объяснение без формул.
- Метрики домена: для e-commerce конверсия и средний чек, для подписок retention и LTV, для финтеха активация и доля активных клиентов.
- Истории из опыта: 3–4 кейса с цифрами и вашей ролью, один про ошибку.
- Портфолио: GitHub или ноутбуки с 1–2 законченными проектами, если опыта мало.
Когда темы повторены, полезно проговорить ответы вслух. Для этого в HireHi есть ИИ-тренажёр собеседований: он проводит голосовое интервью по выбранной роли и грейду и затем показывает разбор.
Шаг 1. Выберите роль, грейд и формат
В форме тренажёра укажите категорию «Аналитика», подкатегорию «Аналитик данных», свой грейд и формат. Технический формат длится около 30 минут и ближе всего к SQL- и статистической секции. HR и финальный форматы короче и полезны перед разговором с рекрутером или руководителем.
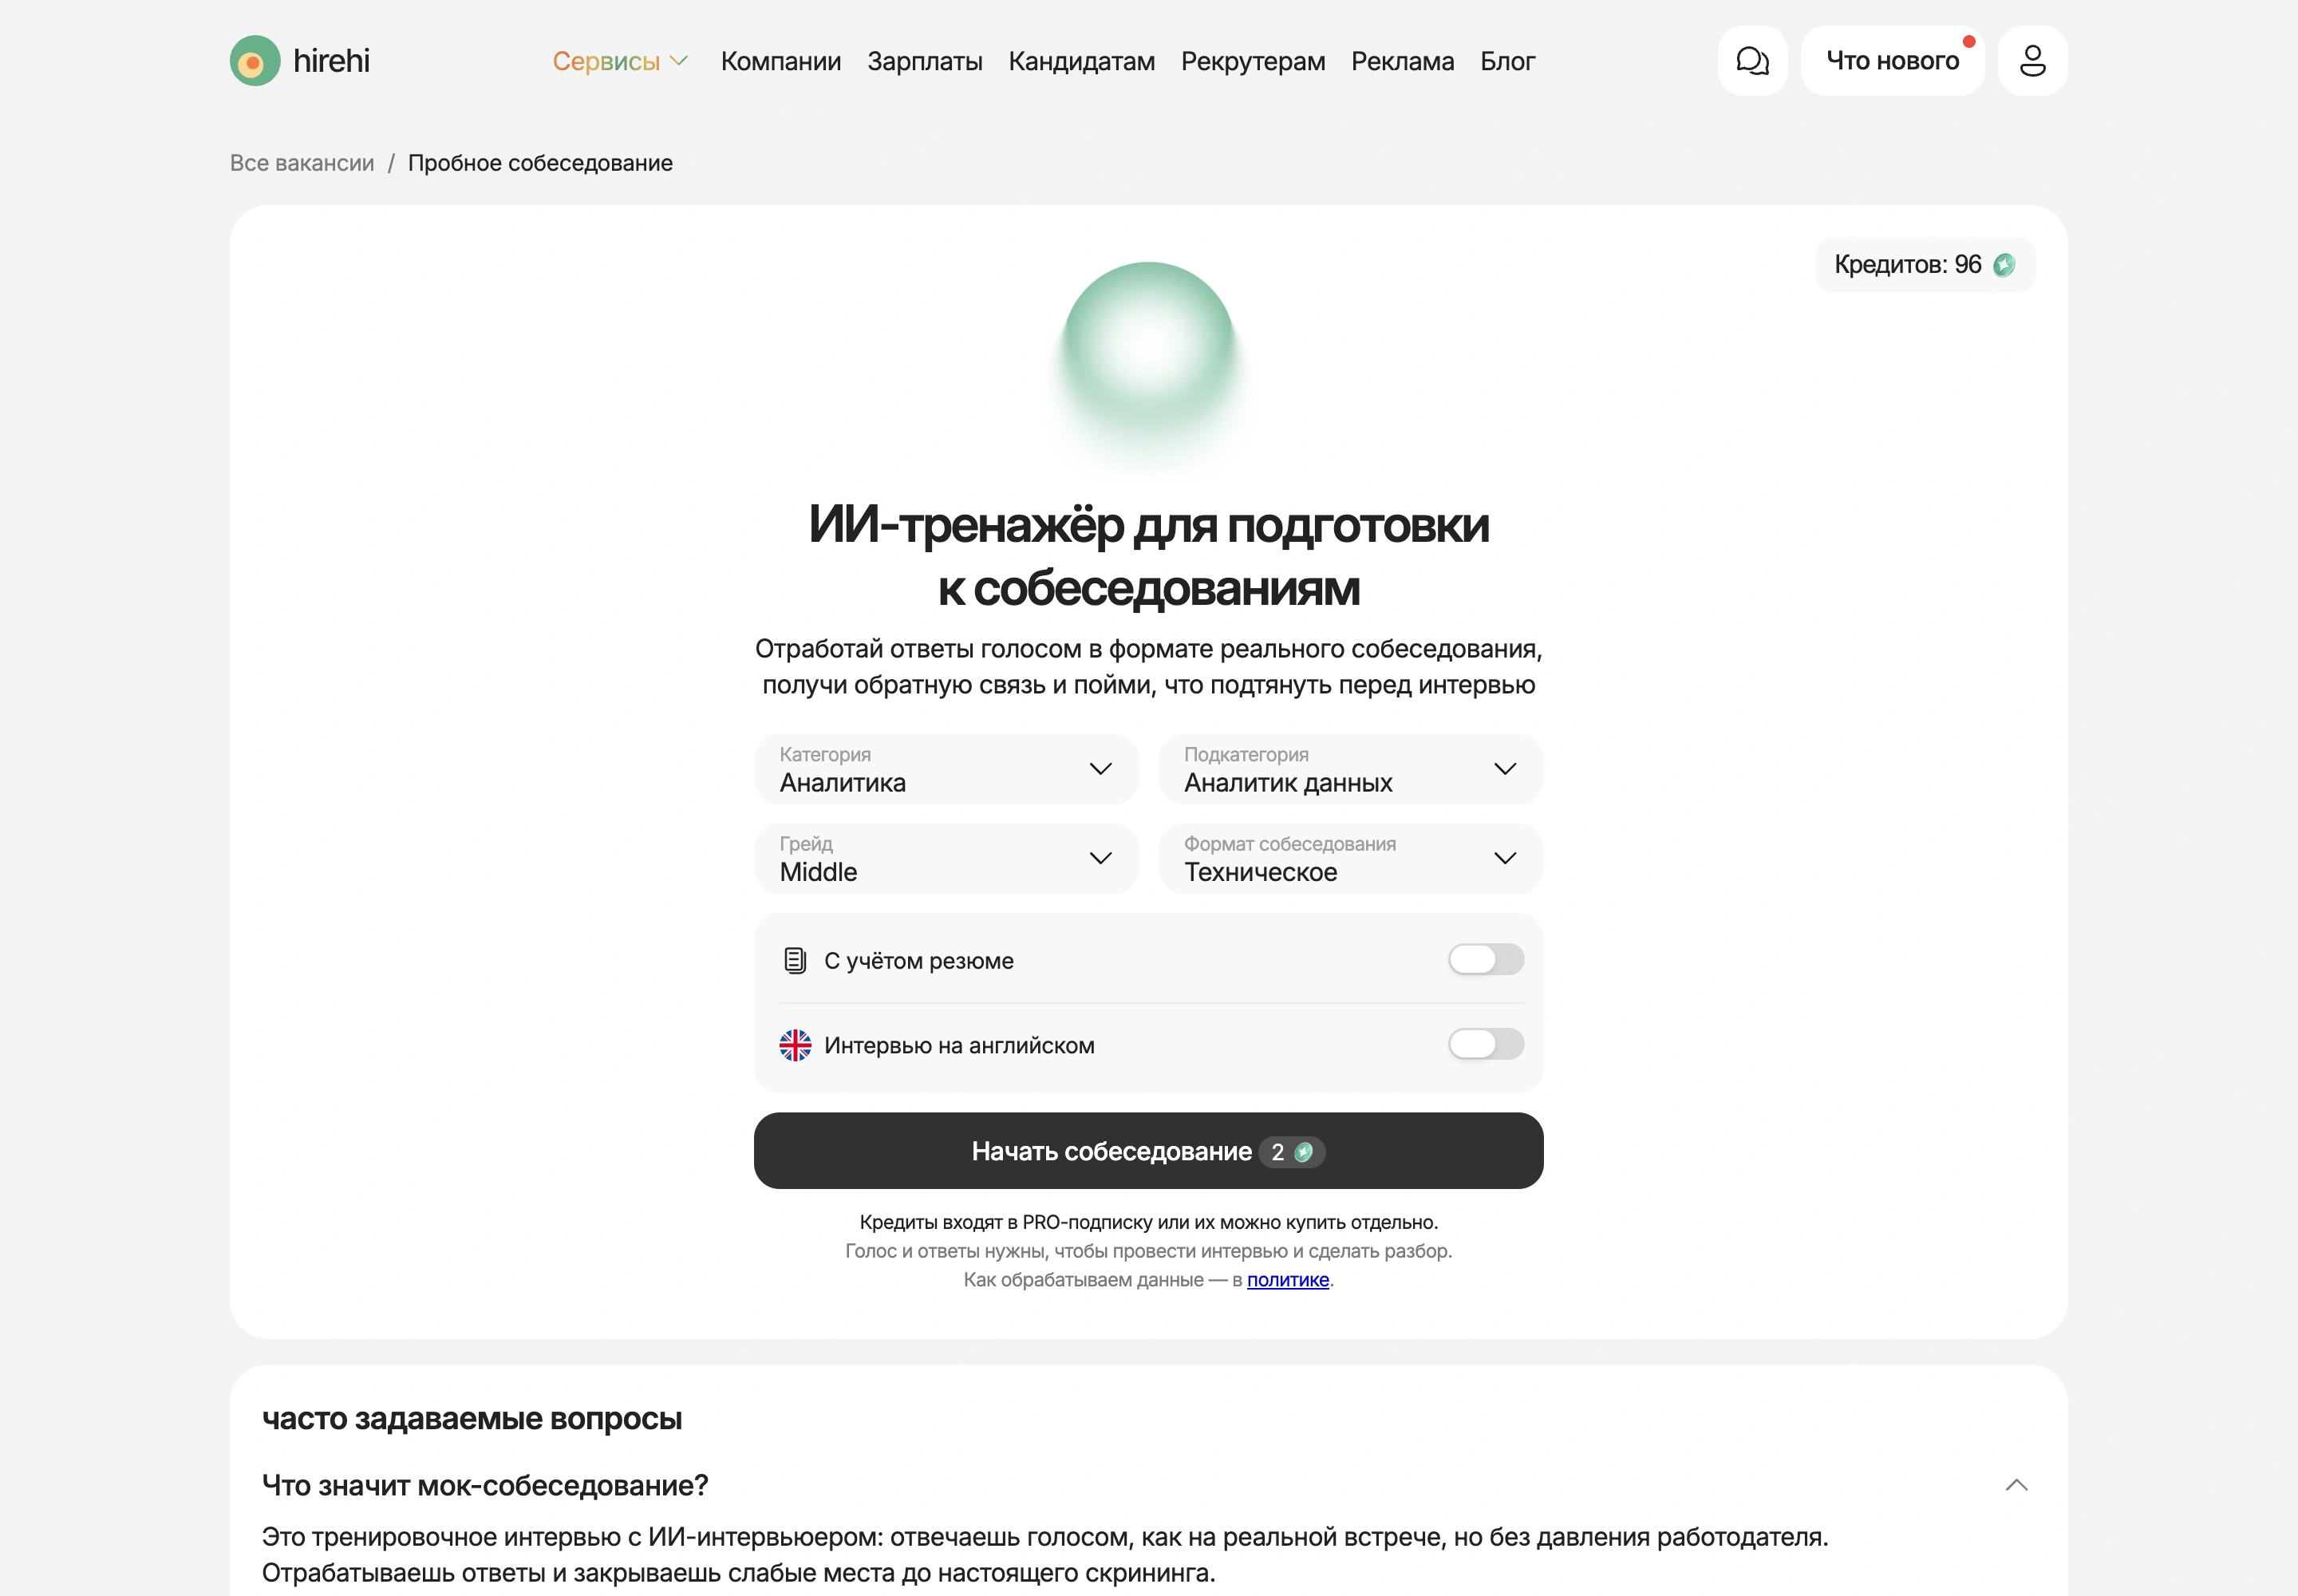
Если резюме уже есть в профиле, включите «С учётом резюме»: вопросы об опыте будут ближе к вашему реальному пути. Для англоязычных вакансий есть режим интервью на английском.
Шаг 2. Запустите интервью и отвечайте вслух
Интервьюер задаёт вопросы голосом, отвечать тоже нужно голосом, как на реальной встрече. Для SQL-вопросов проговаривайте логику запроса: какие таблицы соединяете, как фильтруете, что будет с NULL. Для кейсов начинайте с уточняющих вопросов.
Шаг 3. Изучите результат и разбор
После интервью открывается общий результат и детальный разбор: сильные стороны, зоны роста и рекомендации по конкретным ответам. Сравните его со своими ощущениями. Часто кажется, что сложный вопрос провален, а слабым местом оказывается структура простых ответов.
Шаг 4. Повторите слабые темы и пройдите тренировку снова
Выберите 1–2 темы из зон роста, например A/B-тесты или оконные функции, и вернитесь к соответствующим вопросам выше. Через несколько дней пройдите интервью повторно, можно на грейд выше. Так видно, стали ли ответы короче и точнее.
Как вести себя на собеседовании аналитика данных
Техническое интервью аналитика проверяет ход мысли не меньше, чем правильный ответ. Молчаливое решение задачи оценить сложно, поэтому рассуждайте вслух и показывайте, как проверяете себя.
| Ситуация | Слабое поведение | Сильное поведение |
|---|---|---|
| Задача сформулирована неточно | Сразу писать запрос по своей догадке | Уточнить определение метрики, период и граничные случаи |
| Не помните синтаксис | Замолчать или угадывать | Сказать, что делает конструкция, и написать псевдокод |
| Получили неожиданную цифру | Сразу интерпретировать | Проверить данные на дубли, NULL и фильтры |
| Вопрос про незнакомый инструмент | Приписать себе опыт | Честно сказать и связать с похожим опытом |
| Кейс про падение метрики | Назвать одну причину | Дать план: данные, сегменты, внешние и внутренние факторы |
Ещё одна деталь: говорите о бизнес-смысле цифр. «Retention вырос на 3 пункта» звучит сильнее, если вы добавляете, что это значит для выручки или нагрузки на поддержку.
Какие вопросы задать работодателю на собеседовании аналитика данных
Вопросы работодателю помогают понять, будет ли у вас доступ к данным и влияние на решения. Выберите 3–4 из списка:
- Где хранятся данные и кто отвечает за их качество: отдельная команда инженеров данных или сами аналитики?
- Какой стек используется: хранилище, BI, оркестрация, есть ли dbt или похожий слой метрик?
- Как устроены A/B-тесты: своя платформа, кто проектирует эксперименты и принимает решения?
- Какая доля времени уходит на ad-hoc запросы, а какая на исследования и развитие инструментов?
- С какими командами аналитик работает чаще всего и кто ставит ему задачи?
- Какой анализ за последний год сильнее всего повлиял на продукт или бизнес?
- Как выглядит рост до следующего грейда и кто оценивает результат?